Turnitin AI 检测准确率有多高?哪里靠得住,哪里不稳
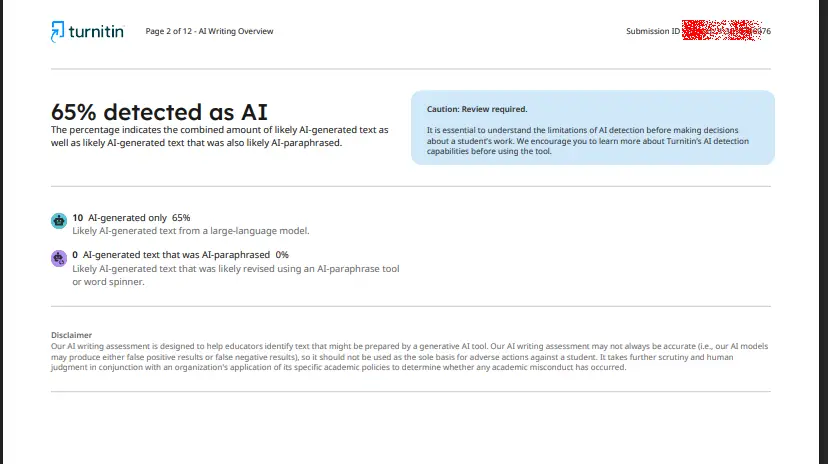
Turnitin 的 AI 检测器在两端可靠,在中间含糊。官方给出的数据是:AI 内容超过 20% 的文档,误报率低于 1%。每个分数能告诉你什么、不能告诉你什么,下面逐条拆开。
检测器到底在测什么
Turnitin 会给每个片段打分,估计它是机器生成的可能性。它不拿你的文字去比对数据库,那是相似度检测做的事。输出是一个概率,不是裁决。
这个区别在分数的高端很明显。90% 说的是摆在工具面前的这段文字,不是你背后的研究。
分数在哪里站得住
准确率的说法范围很窄。Turnitin 公布的是:AI 内容超过 20% 的文档,误报率低于 1%。这覆盖的是本来就带大量机器文本的论文。
对这类论文,检测器有用。高百分比通常指向真实生成的文本,高亮会告诉你哪些句子触发了它。
批量生成的文本会留下一种模式,模型抓得住,疲惫的读者可能漏掉。这个工具就是为这种场景做的,它处理得不错。
在哪里开始不稳
正式的学术书面语是薄弱环节。它天生重复,而这种重复对分类器来说很像机器。
Turnitin 的应对是把 1% 到 19% 的分数藏起来。在这个区间,你看到的是星号,没有百分比也没有高亮,因为误报在这里更集中。星号是怎么回事专门讲了这一段。
2023 年斯坦福的一项研究值得知道。七款通用 AI 检测器把非英语母语者写的托福作文中的 61.22% 判为 AI。那项研究测的不是 Turnitin,但它说明检测器怎么读干净、简单的英语。
简短问答、反思性写作、套模板的实验报告,都落在这个区间。方法部分如果严格照学院模板写,也一样。
Turnitin 在自己的文档里回应了这些情况。和分数较劲之前,值得先读一遍AI 写作检测能力常见问题。
没有 AI 报告的时候
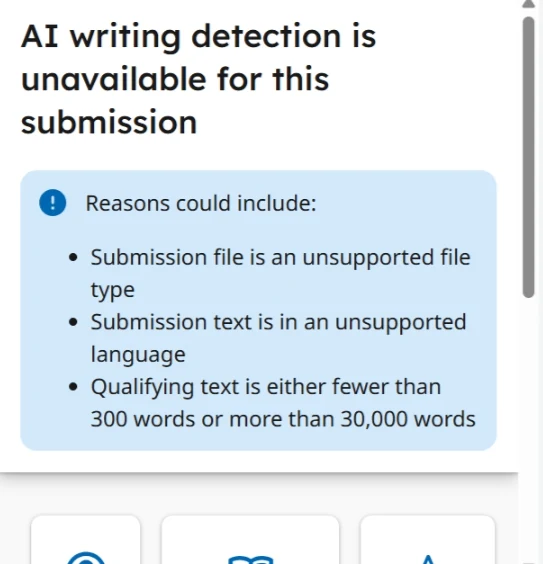
有些文件根本拿不到 AI 分数,这不是准确率问题。报告需要 300–30,000 词正文、小于 100MB 的文件和支持的文件类型。语言也算一条,因为只支持 7 种语言。
如果文件仍然过不了检测,每条原因在报告要求清单里都有对应说明。
AI 分数缺失,首先是覆盖范围的问题,其次才是准确率的问题。下结论说工具坏了之前,先读面板上的文字。
怎么看高亮
一个总分会把结果的形状藏起来。40% 的论文,可能有一大段是生成的,也可能有二十处零散短语。高亮会告诉你哪一种。
把每个被标记的段落和你自己的草稿对照。如果是你写的,你记得句子是怎么一步步变成这样的。这段历史就是最好的证据。
人写的段落里有一句被标出来,是常见结果。把它当成措辞信号,不是认罪书。
百分比不覆盖什么
AI 分数说明不了引用质量。两个数字来自不同系统,互不影响。一篇论文可以相似度 0%、AI 100%,反过来也一样。
它也告诉不了你文本是谁写的。检测器读的是模式,不是作者档案,它看不到你的笔记和草稿。
如果同学的分数比你低,这个差距说明的问题,不如被高亮的段落多。比段落,不要比总分。
怎么用这个数字
把 AI 分数当成复查的提示,不是成绩。
- 0% 表示没有找到证据,不等于证明这些字是你写的。
- 20% 及以上落在 Turnitin 最信任的区间。打开高亮,逐条核对。
- 星号表示检测器无法判断。当成未定,不要当成已澄清。
改稿时把报告和草稿放在一起。这一对材料,能回答教师的大部分问题。
常见问题
AI 分数 0% 能证明是我自己写的吗?
不能。它只表示检测器没有发现机器文本的迹象。这澄清了一项检查,不是作者身份的问题。
为什么报告显示星号而不是数字?
1% 到 19% 的分数会显示为星号,没有百分比,也没有高亮。误报最集中在这个区间。
AI 分数高会拉高相似度分数吗?
不会。相似度分数和 AI 百分比彼此独立,互不影响。
提交前先查一遍——一份报告同时给出相似度分数和 AI 分数。