2026 年读懂 Turnitin 相似度报告:四步顺序
一份 Turnitin 相似度报告,真正要看的只有三块:分数、重合清单,以及清单背后的来源。把分数当成通往来源的入口,而不是判决。下面是阅读顺序。
先看分数,然后放下
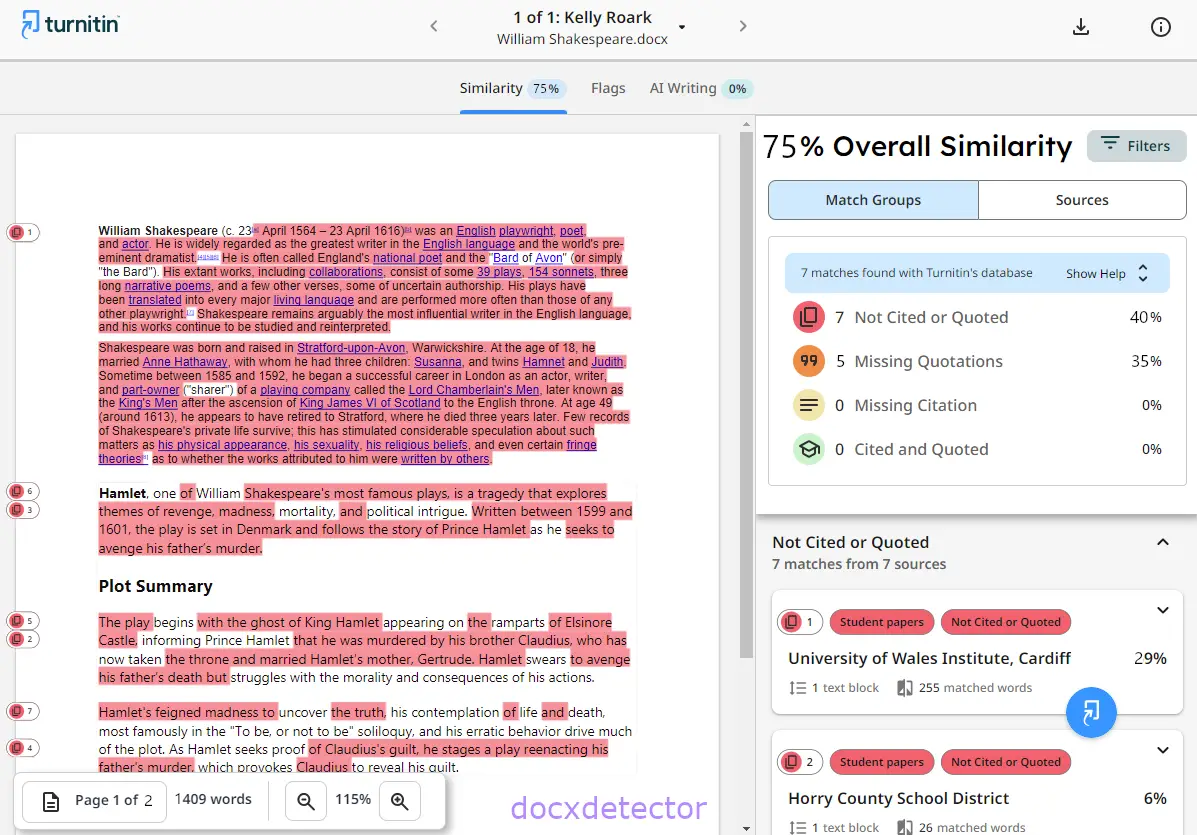
顶部百分比告诉你,你的文字有多少与 Turnitin 数据库中的文档重合。它不告诉你引用是否规范,也不告诉你是不是故意抄的。Turnitin 明确说,没有可接受分数,也没有满分。
所以这个数字看一眼就走。解释它的是清单,单看数字什么都说明不了。
逐条读重合清单
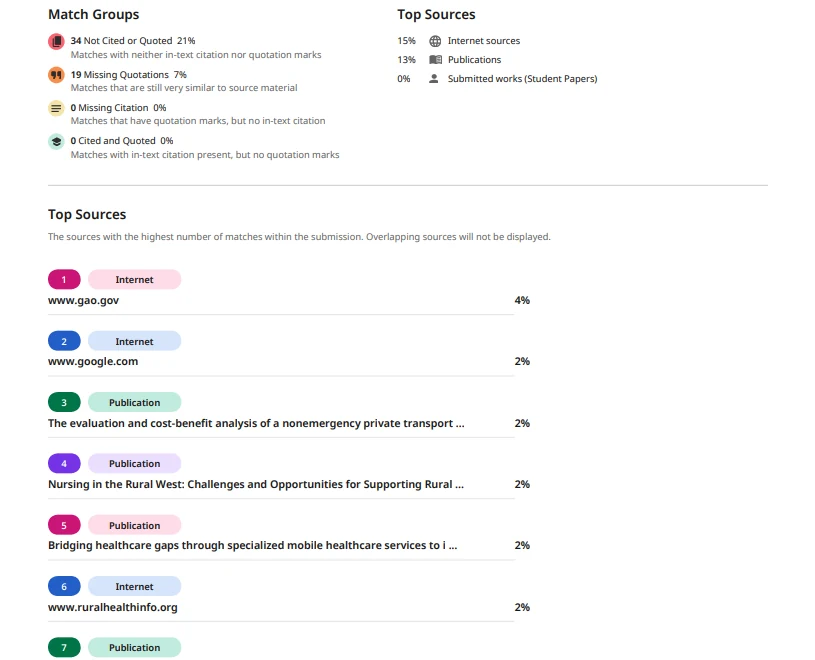
来源列表里每一行,都是一份与你文字有重合的文档。来源旁边的百分比,表示这一条来源覆盖了你论文的多大比例。点开来源,Turnitin 会在你的文中高亮对应文字。
Match Groups 会把重合标为已引用或未引用。未引用意味着 Turnitin 找到了一段引用或改写的文字,附近却没有出处。这一行要先读。
- Not cited:检查这段文字是不是没标注出处就用了。
- Cited:出处有了,但措辞可能仍然贴得太近。
- Small matches:通常是通用短语,一般不用改。
打开高亮文字
点一处重合,报告会跳到文中对应的句子。把你的句子和来源放在一起比,问两个问题:这个观点是我的吗?这个措辞是我的吗?
观点属于别人,就要加引用。措辞跟来源太近,就用自己的句式重写。有引用不能成为照抄措辞的理由。
反应之前先看筛选
Filters and Settings 面板可以排除引文、参考文献和小段重合。打开后数字更干净,反映的是你自己的文字。很多院系不接受筛选后的分数,先确认学校的规定。
这个取舍,在排除引文和参考文献里讲得更细。
清楚分数说不清什么
相似度分数和 AI 写作无关。AI 写作来自另一份报告,有自己的百分比,两个数字互不影响。
如果某个数字看起来不对,通常看它周围的标签就能解释。Turnitin 报告标记与数字这篇逐个讲了这些标签。
把报告当修改清单
从最大的重合改到最小的,一次处理一条来源。每改一轮就重新检测,这样能看出哪处改动消掉了哪处重合。
留一份和最终文件对应的报告。如果之后阅卷人看到的分数不同,这份报告能解释差异。
只读一遍不够。改完再打开一次,因为重写可能在意想不到的地方制造新的重合。上传终稿之前,把干净的版本存好。
常见问题
相似度 20% 算差吗?
单看数字不算。20% 可能是一段规范引用的原文,也可能是一整段照搬,只有重合清单能分辨。
为什么某一条来源的百分比特别高?
单条高重合,通常意味着一大段文字和某份文档重叠。点开看看那段是引用的、标注的,还是都没有。
提交前要不要把所有重合都删掉?
不用。引用和直接引语本来就该重合。只改那些你没必要照搬的措辞。
提交前先检测一遍 —— 一份报告同时给出相似度分数和 AI 分数。