相似度与 AI 分数:两个数字,各管一件事
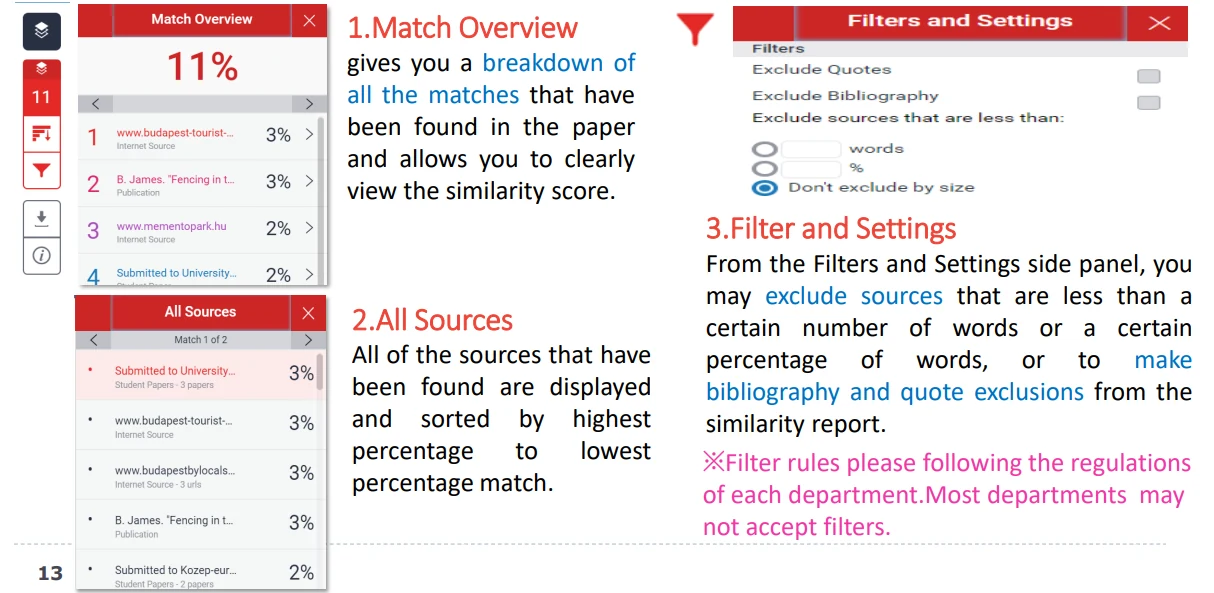
两个数字出现在同一份 Turnitin 报告里,但测的东西不一样。相似度分数拿你的文字和已有来源比对,AI 分数估计的是有多少文字读起来像机器写的。Turnitin 说两者独立,互不影响。
并排对比
| 对比项 | 相似度分数 | AI 写作分数 |
|---|---|---|
| 比对什么 | 你的文字与网页、学生论文、期刊文章 | 你的文字与 AI 生成写作的典型模式 |
| 结果形式 | 重合文字所占的比例 | 被判为 AI 写作的比例 |
| 需要什么 | 至少一条可比对的来源 | 300–30,000 词、受支持的语言、.docx / .pdf / .txt / .rtf、100 MB 以下 |
| 分值较小时 | 直接显示百分比 | 1%–19% 显示星号,不显示高亮 |
每一行回答的是不同的问题。两个数字永远加不到一起,因为它们量的根本不是一回事。
为什么一个高、一个低
一篇引用密集的论文,相似度可能是 30%,AI 分数却是 0%,因为重合的都是引文和参考文献。一份 AI 起草、你又用自己的话改过的稿子,相似度可能只有 2%,AI 分数却很高。
两种情况都正常。两个数字互相解释不了,改好其中一个也不会带动另一个。
两个数字都没有及格线。它们对你的作业意味着什么,由你所在院系决定。
两个分数各在测什么
相似度分数只找 Turnitin 库里存在过的文字。别人没写过的原创分析,分数天然就低。
AI 分数来自对文风的判断,不是查库。检测器读你的文字,估计有多少像它学到的模式。
差别也体现在文件要求上。AI 写作报告需要 300–30,000 词,还要是受支持的语言;相似度报告只要有文字可比对就行。
因为它不去检索来源,所以它可能标记一段根本找不到出处的文字。这就是两栏经常对不上的原因。

按这个顺序看
- 先打开相似度报告,看来源列表。
- 在 Match Groups 里检查 Not Cited 和 Missing。
- 再打开 AI 报告,读被标记的段落。
三步几分钟就能做完。跳过第一步,就会出现把本来就引用规范的文字改坏的情况。
如果 AI 报告根本生成不了,先看文件。检测器需要受支持语言的正文,扫描件或特别短的文件什么都出不来。
先改哪个数字
重合是整段照搬,就先改相似度,补引用、重写都能解决。文字是你自己写的、AI 报告还是标了,就先看 AI 分数。
两件事都在截止前做完。赶时间只改一个,往往会制造出另一个问题。
Turnitin 的AI 检测常见问题说明了第二个数字的局限。Turnitin AI 检测:完整指南讲了报告是怎么生成的。
两个数字都没有公认的临界值。把相似度分数该怎么看和 AI 百分比都当作给老师读的信号,而不是成绩。
常见问题
相似度高,会把 AI 分数也拉高吗?
不会。Turnitin 分开计算,两者不互相提供数据。
老师一般先看哪个数字?
通常是相似度,因为重合内容具体,点开就能看。AI 百分比附带的前提更多,往往需要单独沟通。
为什么我的 AI 报告只显示一个星号?
1% 到 19% 之间显示为星号,也不给高亮,因为这个区间误报更多。把它当信号,别当判决。
提交前先检测一遍 —— 一份报告同时给出相似度分数和 AI 分数。