Turnitin AI 偵測準確度有多高?限制一次看
Turnitin 的 AI 偵測器在兩端可靠,在中間模糊。Turnitin 表示,AI 內容超過 20% 的文件,誤報率低於 1%。以下是每個分數能告訴你什麼、不能告訴你什麼。
偵測器實際量的是什麼
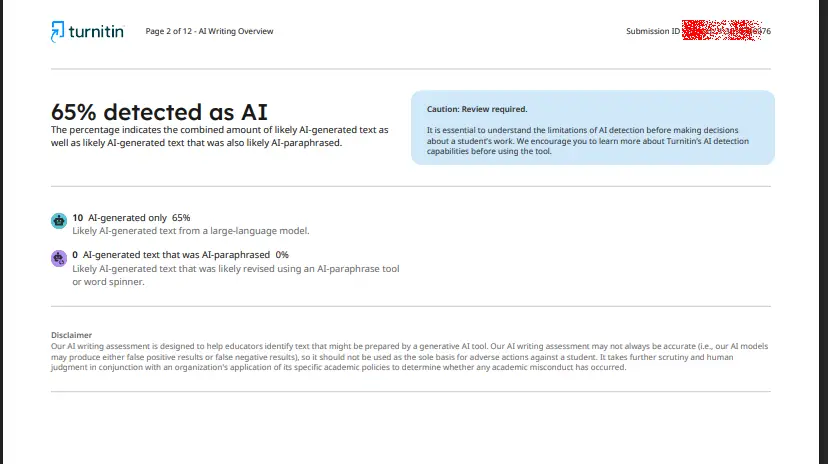
Turnitin 會為每個段落評分,估計它是機器生成的可能性。它不會把你的文字拿去和資料庫比對,那是相似度檢查在做的事。輸出是一個機率,不是判決。
這個差別在量表高端特別重要。90% 的結果描述的是工具眼前這段文字,不是背後的研究。
分數在哪裡站得住腳
準確度的說法範圍很窄。Turnitin 回報,AI 內容超過 20% 的文件,誤報率低於 1%。這涵蓋的是本身已含大量機器文字的文章。
在這些文章上,偵測器很有用。高百分比通常指向真實的生成文字,而標示會指出是哪幾句觸發。
大量生成的文字會留下模式,模型抓得到,疲累的讀者可能漏掉。這正是這套工具被打造出來的情境,而它處理得很好。
哪裡會開始不穩
正式學術文體是弱點。它天生重複,而這種模式在分類器眼中就像機械產出。
Turnitin 的處理方式是隱藏 1% 到 19% 的分數。在這個區間,你只會看到星號,沒有百分比,也沒有標示,因為誤報在這裡更常見。星號的意義有完整說明。
2023 年史丹佛大學的研究值得知道。七款通用 AI 偵測器把非母語者寫的 TOEFL 作文中的 61.22% 判定為 AI。那項研究不是測 Turnitin,但說明偵測器怎麼讀乾淨、簡單的英文。
簡答題、反思寫作、套用範本的實驗報告,都落在這一區。緊跟系上範本的方法章節也一樣。
Turnitin 在自己的文件裡回應了這些情況。在跟分數爭辯之前,AI 偵測常見問答值得先讀一遍。
沒有出現 AI 報告的時候
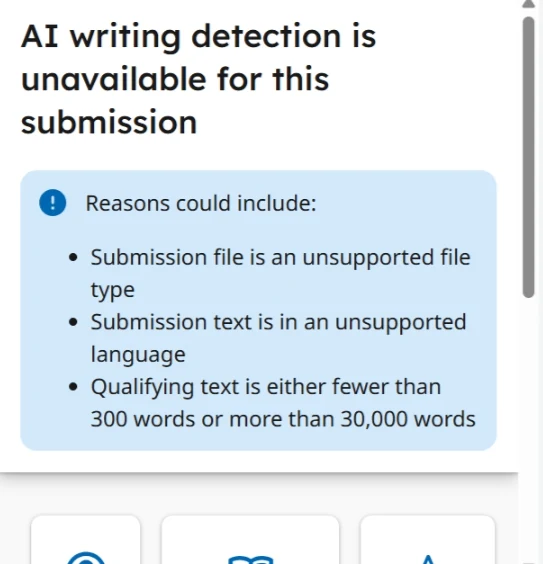
有些檔案拿不到 AI 分數,而那不是準確度問題。報告需要 300 到 30,000 字的正文、小於 100MB 的檔案,以及支援的檔案格式。語言也有關係,因為只支援七種語言。
如果檔案還是不通過檢查,條件清單會逐項說明原因。
AI 分數從缺,首先是涵蓋範圍的問題,其次才是準確度的問題。在你判定工具壞掉之前,先讀面板上的文字。
怎麼讀標示
總分會藏住結果的形狀。40% 的文章,可能是一大段生成內容,也可能是二十個零散詞組。標示會告訴你是哪一種。
把每個被標示的段落和你自己的草稿比對。如果是你寫的,你會記得句子怎麼演變。那段歷史就是你最好的證據。
人類寫的段落裡夾一句被標示的句子,是很常見的結果。把它當成用字訊號,不是自白。
百分比沒有涵蓋的事
AI 分數不談引用品質。這兩個數字來自不同系統,互不影響。一篇文章可以相似度 0%、AI 100%,也可以反過來。
它也不會告訴你文字是誰寫的。偵測器讀的是模式,不是作者紀錄,它看不到你的筆記或草稿。
如果同學的分數比你低,那個差距的意義不如被標示的段落。要比就比段落,不要比總分。
怎麼使用這個數字
把 AI 分數當成提醒你回頭檢視的訊號,不要當成成績。
- 0% 代表沒有找到證據。它不能證明那些字是你寫的。
- 20% 以上落在 Turnitin 最有信心的範圍。打開標示,逐一確認。
- 星號代表偵測器無法判定。請把它當成尚未釐清,而不是已經過關。
修稿時把報告放在草稿旁邊。這兩樣東西能回答老師大部分的疑問。
常見問題
AI 分數 0% 就能證明是我自己寫的嗎?
不行。那只代表偵測器沒找到機器文字的證據。它只代表這項檢查沒有發現問題,作者身分是否釐清則是另一回事。
為什麼我的報告顯示星號而不是數字?
1% 到 19% 的分數會以星號呈現,沒有百分比,也沒有標示。誤報最常集中在這個區間。
AI 分數高會讓相似度分數也變高嗎?
不會。相似度分數和 AI 百分比彼此獨立,互不影響。
提交前先檢查你的文章 —— 一份報告同時給你相似度分數與 AI 分數。