相似度分數與 AI 分數差在哪?兩個數字各有工作
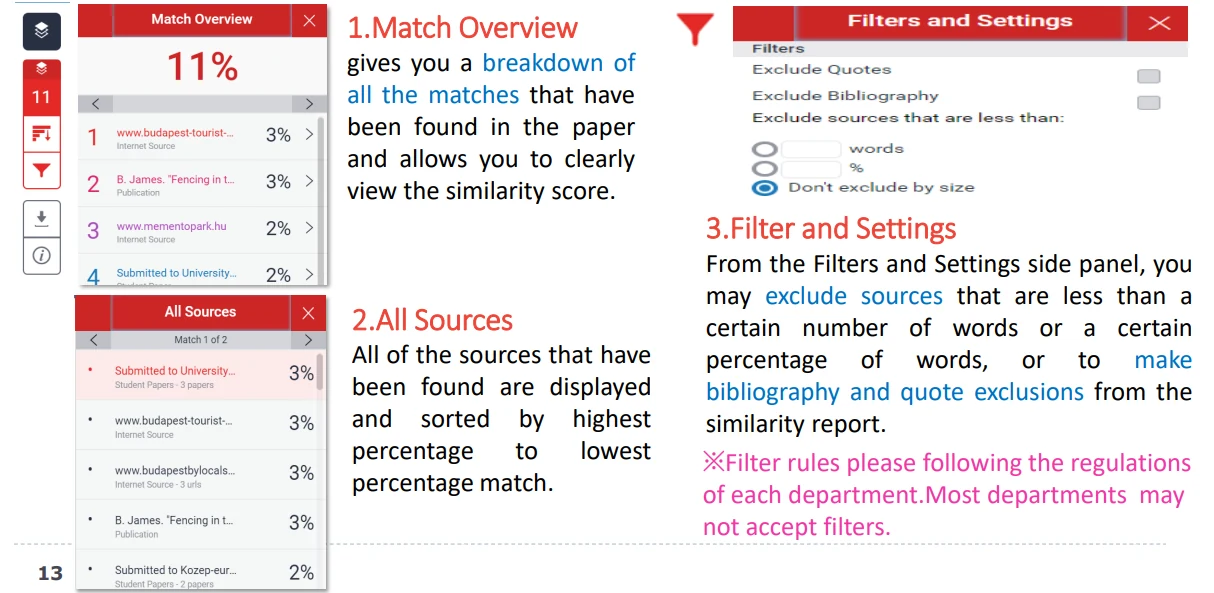
兩個數字都出現在同一份 Turnitin 報告裡,衡量的卻是不同的東西。相似度分數把你的文字跟來源比,AI 分數估計有多少正文看起來像機器生成。Turnitin 說兩者獨立,互不影響。
並排比較
| 問題 | 相似度分數 | AI 寫作分數 |
|---|---|---|
| 比對什麼 | 你的文字與網頁、學生論文、期刊文章 | 你的正文與 AI 生成文字的常見模式 |
| 以什麼呈現 | 比對到的文字比例 | 被判定為 AI 的正文比例 |
| 必要條件 | 至少一個可比對的來源 | 300–30,000 字、支援的語言、.docx / .pdf / .txt / .rtf、小於 100 MB |
| 分數偏低時 | 直接顯示百分比 | 1%–19% 顯示星號,沒有標示 |
每一列回答的問題都不一樣。這兩個數字不能相加,因為它們量的不是同一件事。
為什麼一個高、一個低
引用很多的論文,可能相似度 30%、AI 0%,因為比對到的是引文和參考文獻。你用自己話改寫過的 AI 草稿,可能相似度 2%、AI 分數卻很高。
這兩種情況都正常。兩個數字誰也解釋不了誰,修好其中一邊,另一邊不會跟著動。
兩個數字都沒有及格線。你的作品該怎麼解讀這些數字,由系上決定。
兩個分數各自在量什麼
相似度分數只找得到 Turnitin 收藏庫裡存在的文字。沒有人寫過的原創分析,分數天生就低。
AI 分數來自對文風的判斷,不是查表。偵測器讀你的正文,估計有多少比例像它學過的模式。
這個差別也解釋了檔案規則。AI 寫作報告需要 300–30,000 字和支援的語言,相似度報告只要有文字可以比對就行。
因為它從不搜尋來源,所以能標記跟任何來源都不相符的文字。這就是兩欄經常不一致的原因。

照這個順序讀
- 打開相似度報告,先看來源清單。
- 看 Match Groups 裡有沒有 Not Cited 和 Missing。
- 打開 AI 報告,讀被標示的段落。
三個步驟幾分鐘就能做完。跳過第一步,學生就會去重寫本來引用得好好的文字。
如果 AI 報告完全生不出來,先檢查檔案。偵測器需要支援語言的正文,所以掃描檔或太短的檔案不會回傳任何東西。
該先修哪一個數字
比對到的是複製的段落,就從相似度開始,因為補引用和改寫就能解決。用字是你自己的、報告卻還是標記,就從 AI 分數開始。
兩件都在截止日前做完。趕著修一個問題,常常會生出另一個。
Turnitin 的AI 偵測常見問答說明第二個數字的限制。Turnitin AI 偵測的背景說明則交代報告是怎麼組出來的。
兩個數字都沒有公認的門檻。把相似度分數那個問題和 AI 百分比,都當成給教師讀的訊號,不是成績。
常見問題
相似度分數高,AI 分數也會跟著高嗎?
不會。Turnitin 分開計算,兩者不會互相餵養。
教師通常先看哪個數字?
通常是相似度分數,因為比對具體、容易打開。AI 百分比附帶的但書比較多,往往需要談一談。
為什麼我的 AI 報告只顯示星號?
1%–19% 的分數會以星號呈現,沒有標示,因為誤報在這個區間比較常見。把它當訊號,不是判決。
提交前先檢查你的文章 —— 一份報告同時給你相似度分數與 AI 分數。